
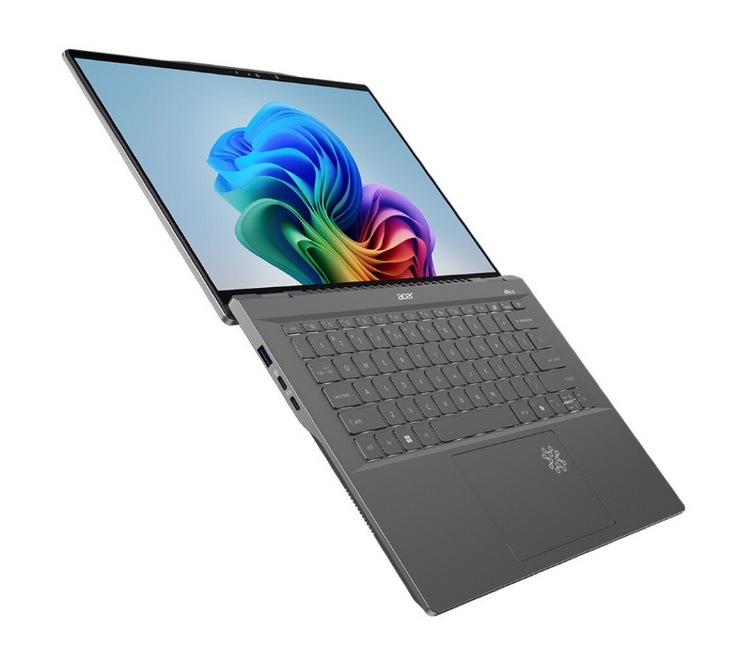
最近后台问 Acer Swift 14 AI 的人不少,问题也很集中:1.3kg 出头的机身,加上标称 40 TOPS 以上的 NPU,到底能不能当 AI 轻薄本用?先说清楚,Swift 14 AI 其实有两个平台版本:骁龙 X Elite 的 SF14-11,和后来 Intel Core Ultra 200V / Lunar Lake 的 SF14-51。买它的人基本冲两点:轻,和那个 NPU。但说真的,真拿它跑模型,卡你的往往不是算力,是接口和内存。
一、先分清版本:骁龙版和 Lunar Lake 版不是同一台机器
很多人把 Swift 14 AI 当成一个型号看,其实两个平台差异很大。
**SF14-11:骁龙 X Elite 平台。** 12 核 Oryon CPU,Adreno GPU,Hexagon NPU 标称 45 TOPS,主打能效和 Copilot+ PC 常驻 AI 功能。优点是续航好、离电性能稳;缺点是 Windows on Arm 生态仍有兼容性摩擦,部分 x86 专业软件、驱动、AI 工具链需要转译或原生适配。
**SF14-51:Intel Core Ultra 200V / Lunar Lake 平台。** 4 个 P 核加 4 个低功耗 E 核,Arc 140V 核显,NPU 4 标称 48 TOPS,平台总 AI 算力更高。它的优势是 x86 兼容性更稳,OpenVINO、Vulkan、SYCL 这些本地 AI 工具链更成熟,外接显卡坞的可行性也比骁龙版更现实。
先说结论:如果只是会议降噪、背景虚化、实时字幕,两个版本都能打;如果要折腾本地大模型、外接显卡坞、跑 x86 AI 工具,Lunar Lake 版更省心。
二、便携这块,AI 负载是唯一的变数
重量 1.36kg 上下,14 英寸级别的 2.5K 触控屏,日常通勤、开会、咖啡馆写代码,便携性没得挑。问题在于 AI 推理是持续负载,不是跑个分就结束。
这类轻薄本基本是单风扇加双热管的散热规格,PL1 通常压在 15W 到 20W 级别,PL2 短时冲高,具体看厂商设定。短时间跑推理没问题,连续压十几分钟,频率就会往下掉。所以它的「AI 效能」本质上是短时爆发型,不是持续型。你要把它当 7×24 的推理节点,那是用错场景了。
举个很典型的场景:用 Ollama 或 llama.cpp 跑 Llama 3.1 8B Q4_K_M,短时间大概能看到十来个 token/s,风扇还没完全转起来;连续对话十分钟后,机身温度上来,频率回落,速度可能掉到个位数。这个速度不是不能用,但和「生产力主力」有距离。
续航也一样。轻办公场景撑大半天到一天问题不大,但你要是挂着模型一直跑,掉电速度是办公场景的好几倍,这时候基本就得插着电用。而一旦插电,接口分配的问题就来了。
三、接口够不够用,得看你怎么接
先列清单,两个版本大同小异:2×USB-C(USB4 或雷电 4,支持 PD 供电和 DP 输出)、2×USB-A 3.2、HDMI 2.1、microSD 读卡器、3.5mm 耳机孔。
表面看很全,比很多只给两个 C 口的轻薄本良心。但对 AI 场景,问题出在 USB-C 的数量上:
**一个 C 口要留给充电。** 跑推理时功耗上去了,电池撑不住,基本得一直插着 PD 电源。原装适配器功率以机型为准,但重载时最好接 100W 级别 PD;扩展坞如果 PD 供电不够,边充边跑会掉电。很多 PD 输入偏低的扩展坞,在 CPU+GPU+NPU 同时负载时供电余量不够,电池会缓慢往下掉。
**剩下一个 C 口,接了外屏就接不了别的。** 想同时外接显示器看推理日志、再接个 USB 加速设备或者采集卡,就得上扩展坞。好在雷电 4 / USB4 扩展坞现在价格下来了,这是最省事的解法。
**想外接显卡坞?** USB4 的 40Gbps 带宽大致相当于 PCIe 3.0 x4 的水平,实际可用带宽还要再打折。跑推理确实比核显强,但和台式机的直连插槽不是一个量级,延迟和带宽都是瓶颈,别抱太高期望。尤其是骁龙版,Windows on Arm 下的 eGPU 兼容性更复杂,Lunar Lake 版相对更值得尝试。
USB-A 两个口倒是实在,键盘鼠标 U 盘随便插。HDMI 2.1 能直出 4K 高刷,这点比一堆只给单 C 口的机器强,属于加分项。不过要注意,有些轻薄本的 HDMI 2.1 是 TMDS 版本,实际带宽只到 4K 60Hz;如果 Acer 给的是 FRL 版本,4K 120Hz 才更稳。买前最好查具体规格。
microSD 读卡器也是同理,多数是 UHS-I 速度,传照片够用,但别指望它当高速素材盘。
四、NPU 那 40 多 TOPS,到底能干什么
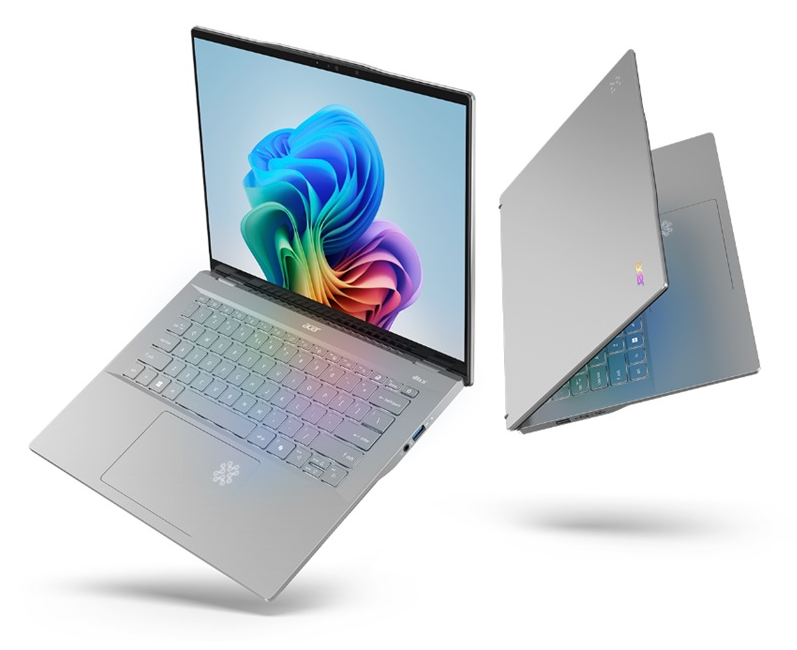
骁龙 X Elite 的 Hexagon NPU 标称 45 TOPS,Lunar Lake 的 NPU 4 标称 48 TOPS,都是 INT8 峰值。Copilot+ PC 的门槛是 40 TOPS,这俩都过了线。
但峰值 TOPS 和跑大模型,是两件事:
– **NPU 擅长的是常驻小模型**——视频会议降噪、背景虚化、实时字幕、图像分割这类。功耗低、不占 CPU,这才是它真正的价值。Windows Studio Effects、Live Captions、Recall 类功能,都是 NPU 的舒适区。
– **跑 LLM,瓶颈在内存带宽和算子支持。** NPU 对 transformer 的支持还在补,实际能顺畅跑的多是量化过的小模型。llama.cpp 这类工具更多还是走 CPU、核显或专用后端,NPU 不是默认选项。
– **真正能用的还是 CPU + 核显。** LPDDR5X 双通道给到百 GB/s 级的带宽,7B / 8B 的 Q4 量化模型(约 4-5GB)装得下,也能跑起来,但速度就是「能用」级别,别指望当生产力主力。
这里有个容易被忽略的账:7B 模型 Q4 量化后约 4GB,每生成一个 token 都要把权重读一遍。如果内存带宽按 136 GB/s 这个级别算,理论极限也就 30 token/s 左右,实际效率再打折,能稳在十来个 token/s 就算不错。14B Q4 约 8GB,理论极限减半,实际可能只有个位数;32B Q4 约 18GB,32GB 版本勉强能装,但速度会掉到 2 到 3 token/s 级别。所以「跑得动」和「跑得快」是两码事。
上下文长度也会吃内存。以 8B 模型为例,KV Cache 在 4K 上下文下可能占几百 MB,到了 32K 上下文,可能多出几个 GB。16GB 版本本来就被系统和浏览器占掉一部分,再开长上下文,很容易爆内存。
这里有个坑要提醒:**内存是板载的,买定离手。** 16GB 版本跑模型要留意,模型占 4-5GB,系统再吃一部分,多开几个应用和浏览器标签就紧张了。要真想跑模型,32GB 版本更稳,这钱别省。
五、几个真实场景,看看它到底适合谁
**场景一:移动办公 + 会议 AI。** 1.3kg 机身,2.5K 触控屏,NPU 负责背景虚化、降噪、实时字幕,轻办公续航能撑大半天到一天。这是 Swift 14 AI 最舒服的状态,也是 Copilot+ PC 的本意。
**场景二:咖啡馆写代码 + 本地小模型。** 跑 7B/8B Q4 模型,短时间速度能接受,但风扇会转,机身会热,电池掉得快。适合临时查资料、写摘要、做翻译,不适合长时间批量推理。
**场景三:桌面扩展。** 一个雷电 4 扩展坞接 4K 显示器、2.5G 网卡、移动 SSD,同时给笔记本 100W PD 供电;HDMI 直出副屏;USB-A 接键鼠。这样接口才够用。没有扩展坞,两个 C 口会非常紧张。
**场景四:外接显卡坞。** Lunar Lake 版通过雷电 4 接 RTX 3060 级别显卡,跑 7B/8B 模型速度会明显提升,但大模型依然受限于显存和带宽。它适合偶尔加速,不适合当推理服务器。
**场景五:和 MacBook Air、游戏本对比。** MacBook Air M 系列统一内存带宽不错,本地小模型体验稳,但 x86 工具兼容性不同;游戏本 RTX 4060 跑模型快得多,但重量和续航完全不是一类产品。Swift 14 AI 的定位就在中间:轻、能跑、但不快。
六、可操作的优化点
– 电源模式调到最佳性能,Windows 默认的平衡模式会压 PL1,推理速度肉眼可见地掉。
– 垫高机身、别放床上,进风口堵住温度墙来得更快。
– 控制上下文长度,长上下文对内存和算力的消耗是平方级的,能短就短。
– 模型选 Q4_K_M 量化,这是速度和质量的甜点区,再往上压质量掉的明显。
– Intel 版优先试 Vulkan 或 SYCL 后端,Arc 核显能分担一部分矩阵运算;骁龙版优先看 QNN 或 CPU 后端,别硬等 NPU 全量支持。
– 扩展坞选 100W PD 输入,否则边跑边充会掉电。
– 16GB 版本少开浏览器标签,模型加载前先清内存。
七、结论
**便携:拿捏。** 1.3kg 出头,带着走没负担,这是它最大的卖点。
**接口:日常够用,AI 场景偏紧。** 两个 C 口一个充电一个外设,想同时接屏加加速设备就得上扩展坞。雷电 4 扩展坞是刚需,不是可选项。
**AI 效能:NPU 适合常驻轻量任务,跑大模型是「能跑但不快」。** 它的定位是 Copilot+ PC,不是推理工作站。7B/8B Q4 模型能跑,14B 勉强,32B 很吃力,70B 基本别想。
**适合谁:** 要一台轻、续航好、偶尔跑跑小模型的机器,顺手用 NPU 加速日常 AI 功能,同时需要 Windows x86 生态或长续航 Arm 生态的人。
**不适合谁:** 指望它当推理主力,或者想长期挂模型跑任务的人。
最后说句实在的,这类机器的分水岭不是参数表,而是内存、接口和散热。你手上这台 Swift 14 AI 是骁龙版还是 Lunar Lake 版?跑模型的实际体感怎么样,评论区聊聊。
数码科技资讯 站点: szbjb
相关阅读:深圳笔记本报价


